

OpenAI宣布將替ChatGPT與Codex產生的文字加入「隱形浮水印」,率先在歐盟上路,根據OpenAI指出,浮水印不是肉眼看得到的符號,是透過調整AI產生文字時的用字選擇,留下機器可辨識的統計訊號,未來可用來判斷一段文字是否可能經過OpenAI模型生成。
OpenAI於10月5日公布新的文字來源辨識機制「textGrain」,因應歐盟《AI法案》對AI生成內容的透明度要求,官方表示,未來幾週內,將陸續替歐盟地區符合資格的ChatGPT及Codex文字輸出加入隱形浮水印,而且適用所有ChatGPT方案。不過,目前並非全球ChatGPT用戶都會被強制加上浮水印。
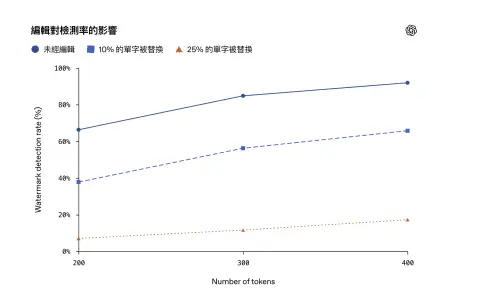
▲OpenAI測試顯示,文字經過編輯後,隱形浮水印的偵測率會明顯下降;若替換10%單字,偵測率大幅降低,替換25%後更可能降至不到2成。(圖/OpenAI)
「隱形浮水印」藏在哪?
所謂textGrain,並不是在文章裡塞入看不見的Unicode字元、空白或特殊標點。OpenAI解釋,AI每產生下一個字詞時,會從多個可能的詞彙中選擇,textGrain則會微幅調整這些字詞被選中的機率,讓整段文章形成特定的統計模式。使用相對應的偵測器分析後,就有機會判斷文字是否帶有OpenAI的浮水印訊號。
改寫就能洗掉?OpenAI坦言「並非百分之百抓得到」
不過,這套技術並非萬無一失,OpenAI測試顯示,在誤判率設定為1%的情況下,約200 tokens長度的文章,浮水印偵測率約80%;文章增加至400 tokens後,偵測率可提高到約95%。但數學等用字選擇較少、表達方式較固定的內容,辨識效果會明顯下降。
而且改寫文章可能削弱浮水印。OpenAI測試400 tokens的英文文章時,若將10%的字詞替換成同義詞,偵測率會從約92%降至66%,若替換25%的文字,偵測率更降至17%。大幅改寫、改述或翻譯,也可能讓浮水印變得難以辨識。
被驗出AI浮水印=整篇都是AI寫的?
另一個容易產生誤會的地方是,即使文章被偵測出OpenAI浮水印,也不代表可以直接認定「整篇都是ChatGPT寫的」。OpenAI特別說明,浮水印只能顯示OpenAI系統「可能曾產生或處理過」部分文字,無法判斷人類究竟修改了多少,也無法辨識是哪一名使用者、哪個帳號或哪一段提示詞生成,更不能藉此判定文章所有權、法律責任或內容真假。
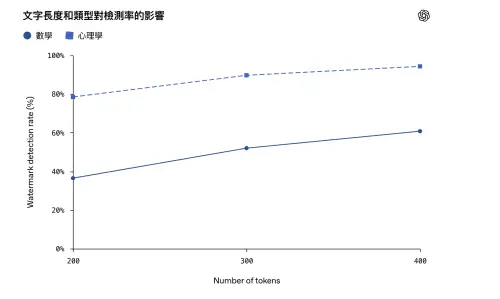
▲OpenAI指出,文字越長,浮水印偵測率通常越高,不同內容類型也會影響辨識效果;以官方測試來看,心理學類文字的偵測率明顯高於數學類內容。(圖/OpenAI)
我是廣告 請繼續往下閱讀
所謂textGrain,並不是在文章裡塞入看不見的Unicode字元、空白或特殊標點。OpenAI解釋,AI每產生下一個字詞時,會從多個可能的詞彙中選擇,textGrain則會微幅調整這些字詞被選中的機率,讓整段文章形成特定的統計模式。使用相對應的偵測器分析後,就有機會判斷文字是否帶有OpenAI的浮水印訊號。
改寫就能洗掉?OpenAI坦言「並非百分之百抓得到」
不過,這套技術並非萬無一失,OpenAI測試顯示,在誤判率設定為1%的情況下,約200 tokens長度的文章,浮水印偵測率約80%;文章增加至400 tokens後,偵測率可提高到約95%。但數學等用字選擇較少、表達方式較固定的內容,辨識效果會明顯下降。
而且改寫文章可能削弱浮水印。OpenAI測試400 tokens的英文文章時,若將10%的字詞替換成同義詞,偵測率會從約92%降至66%,若替換25%的文字,偵測率更降至17%。大幅改寫、改述或翻譯,也可能讓浮水印變得難以辨識。
被驗出AI浮水印=整篇都是AI寫的?
另一個容易產生誤會的地方是,即使文章被偵測出OpenAI浮水印,也不代表可以直接認定「整篇都是ChatGPT寫的」。OpenAI特別說明,浮水印只能顯示OpenAI系統「可能曾產生或處理過」部分文字,無法判斷人類究竟修改了多少,也無法辨識是哪一名使用者、哪個帳號或哪一段提示詞生成,更不能藉此判定文章所有權、法律責任或內容真假。